
マルチモーダルAiとは何か?仕組みと活用事例を完全解説

マルチモーダルAiとは何か?仕組みと活用事例を完全解説についての最新情報をご紹介します。
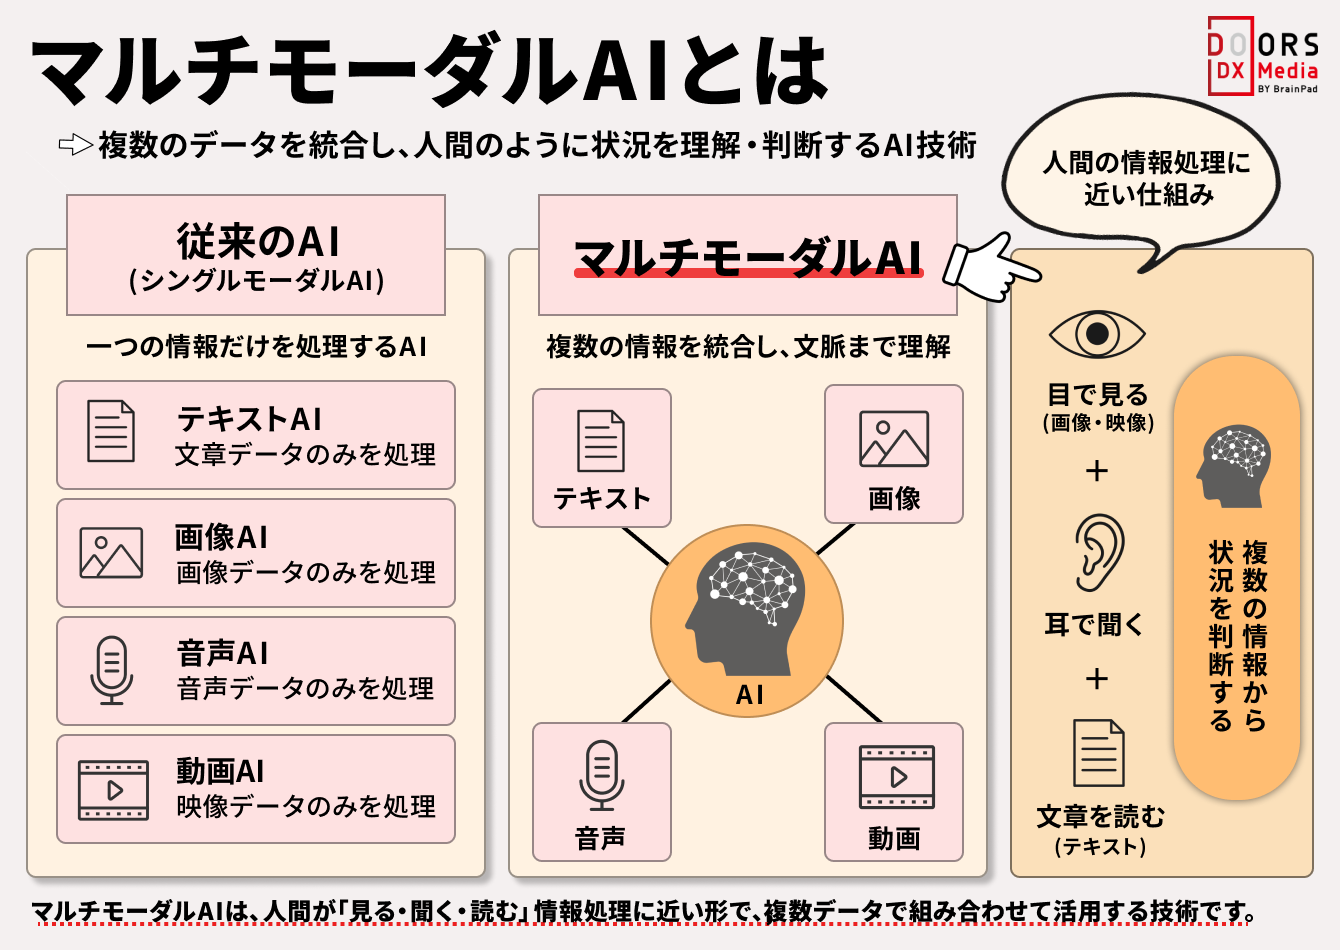
マルチモーダルAIの基礎を理解する鍵は、「モダリティ(Modality=情報の種類・様式)」の統合にあります。私たちが日常会話をするとき、相手の言葉(テキスト・言語)だけでなく、表情(視覚情報)や声のトーン(音声情報)、身振り手振りを総合して意図を汲み取っているのと同じ構造です。
従来のAIは、テキストなら自然言語処理、画像なら画像認識、音声なら音声認識と、領域ごとにモデルが完全に独立した「シングルモーダルAI」でした。たとえば、動画から音声を抜き出して文字起こしをし、そのテキストを別のAIに要約させ、さらに画像解析AIでフレームを調べるというように、複数のツールを無理やり連結(パイプライン処理)していたため、処理の遅延や文脈の欠落が避けられませんでした。
これに対し、近年のマルチモーダル大規模言語モデル(MLLM)は、最初から画像・音声・テキストを同一のベクトル空間(エンベディング空間)で同時に学習しています。画像認識と音声認識が別々の機能として存在するのではなく、1つの巨大な脳の中で「見ている映像のこの部分について、この声のニュアンスで質問された」という複合的な文脈をミリ秒単位で直接解釈できる点が、従来の生成AIとの決定的な違いです。
暮らしを豊かにする便利アイテムや時短アイデアを中心に、実用的な情報をお届けします。
