
【完全版】度数分布表の平均値はどう計算する?仮平均の裏ワザまで徹底解説

【完全版】度数分布表の平均値はどう計算する?仮平均の裏ワザまで徹底解説について見逃せない 事実を厳選して解説いたします。
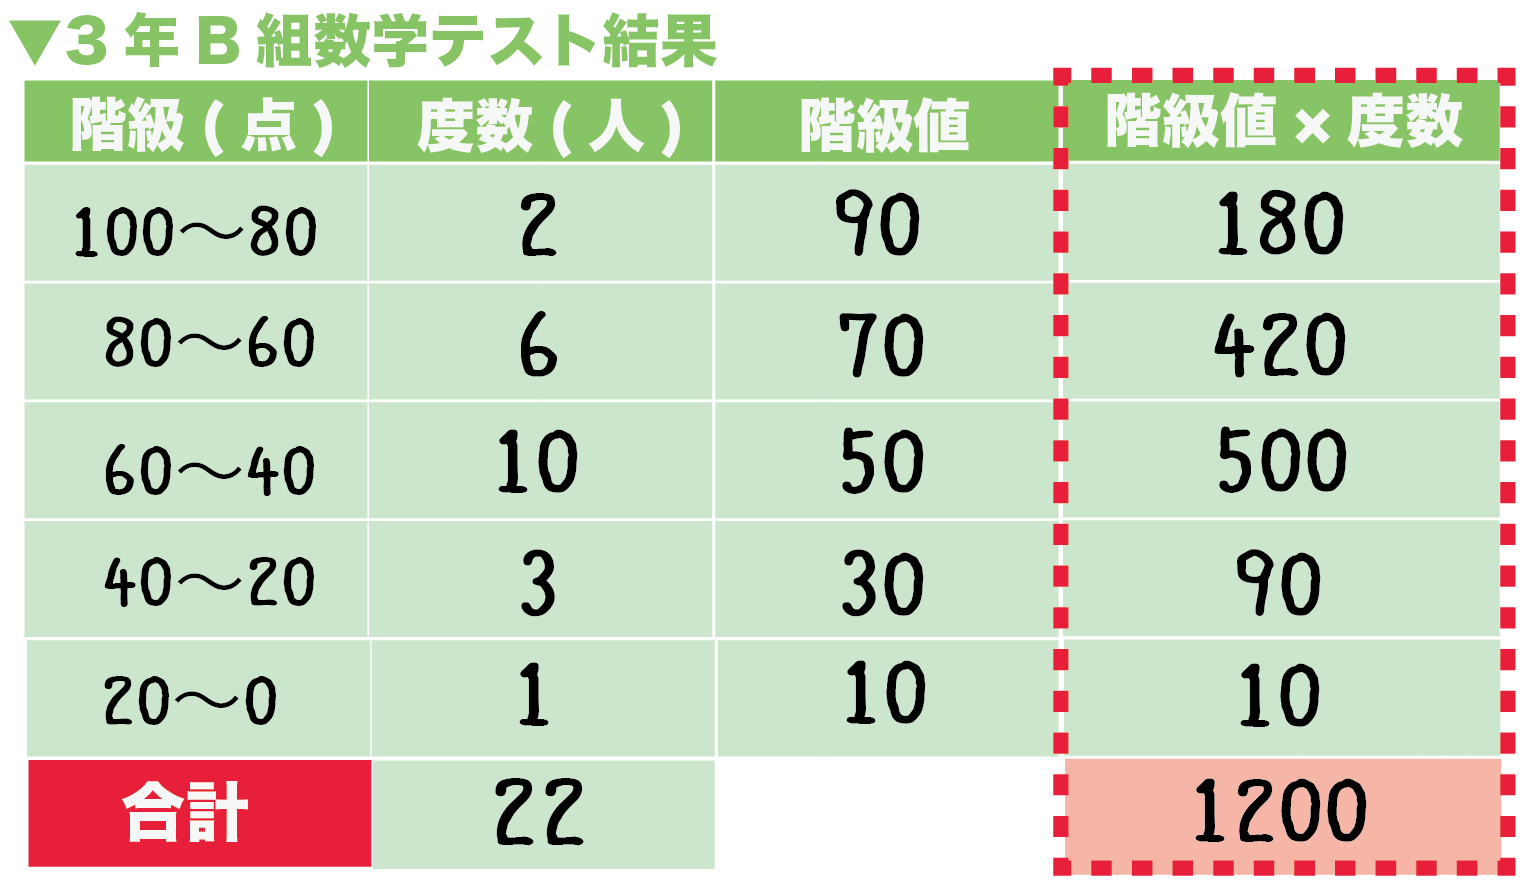
Web上の解説記事や初学者向けフォーラムでは、「平均値さえ出しておけば分布の特徴は掴める」といった単純化された説明が散見されます。しかし、これは統計実務における大きな落とし穴です。
代表的な事例が「日本の世帯所得」や「金融資産保有額」のデータです。一部の超富裕層(極端な外れ値)が存在する場合、平均値は実態よりも大幅に高く引き上げられます。このような左右非対称な歪んだ分布に対しては、度数分布表から平均値だけを抽出しても、一般的な市民感覚(ボリュームゾーン)を見誤ることになります。
さらに、度数分布表を作成する際の「階級の幅」の設定にも注意が必要です。階級の幅を広くしすぎると細かな分布の山が潰れてしまい、逆に狭すぎると度数が0の階級が頻発して全体像が見えなくなります。統計学の標準的な指針としては、データ数 $N$ に対して階級数を $\approx 1 + \log_2(N)$ 程度に設定する「スタージェスの公式」などが広く支持されています。
【プロの結論】度数分布表の活用に向いている人・慎重になるべき人の判断基準
度数分布表およびその平均値の活用には、データの性質に応じた明確な適性があります。
- 積極的に活用すべきケース:
- 数千〜数万件規模の大量データがあり、全体の概要や正規分布に近いデータの中心傾向を素早く把握・報告したい場合。
- 個人情報保護の観点から個別の実数値を公開できず、区間ごとの人数のみが開示されている公的統計を取り扱う場合。
- 慎重な検証が必要なケース:
- データ数が極端に少なく(20件未満など)、1件の値のズレが階級値の仮定に大きな誤差を生じさせる場合。
- 所得データやウェブサイトの滞在時間のように、ごく少数の巨大な数値(ロングテール)が存在し、中央値や最頻値の併用が必須となる場合。
Webメディアでの編集・執筆歴10年。読者の好奇心を刺激するストーリー作りを心がけています。
