
なぜバイト順序は統一されない?エンディアンの違いと仕組み・完全解説

なぜバイト順序は統一されない?エンディアンの違いと仕組み・完全解説の基礎知識と応用に迫る! わかりやすい言葉で紐解きます。
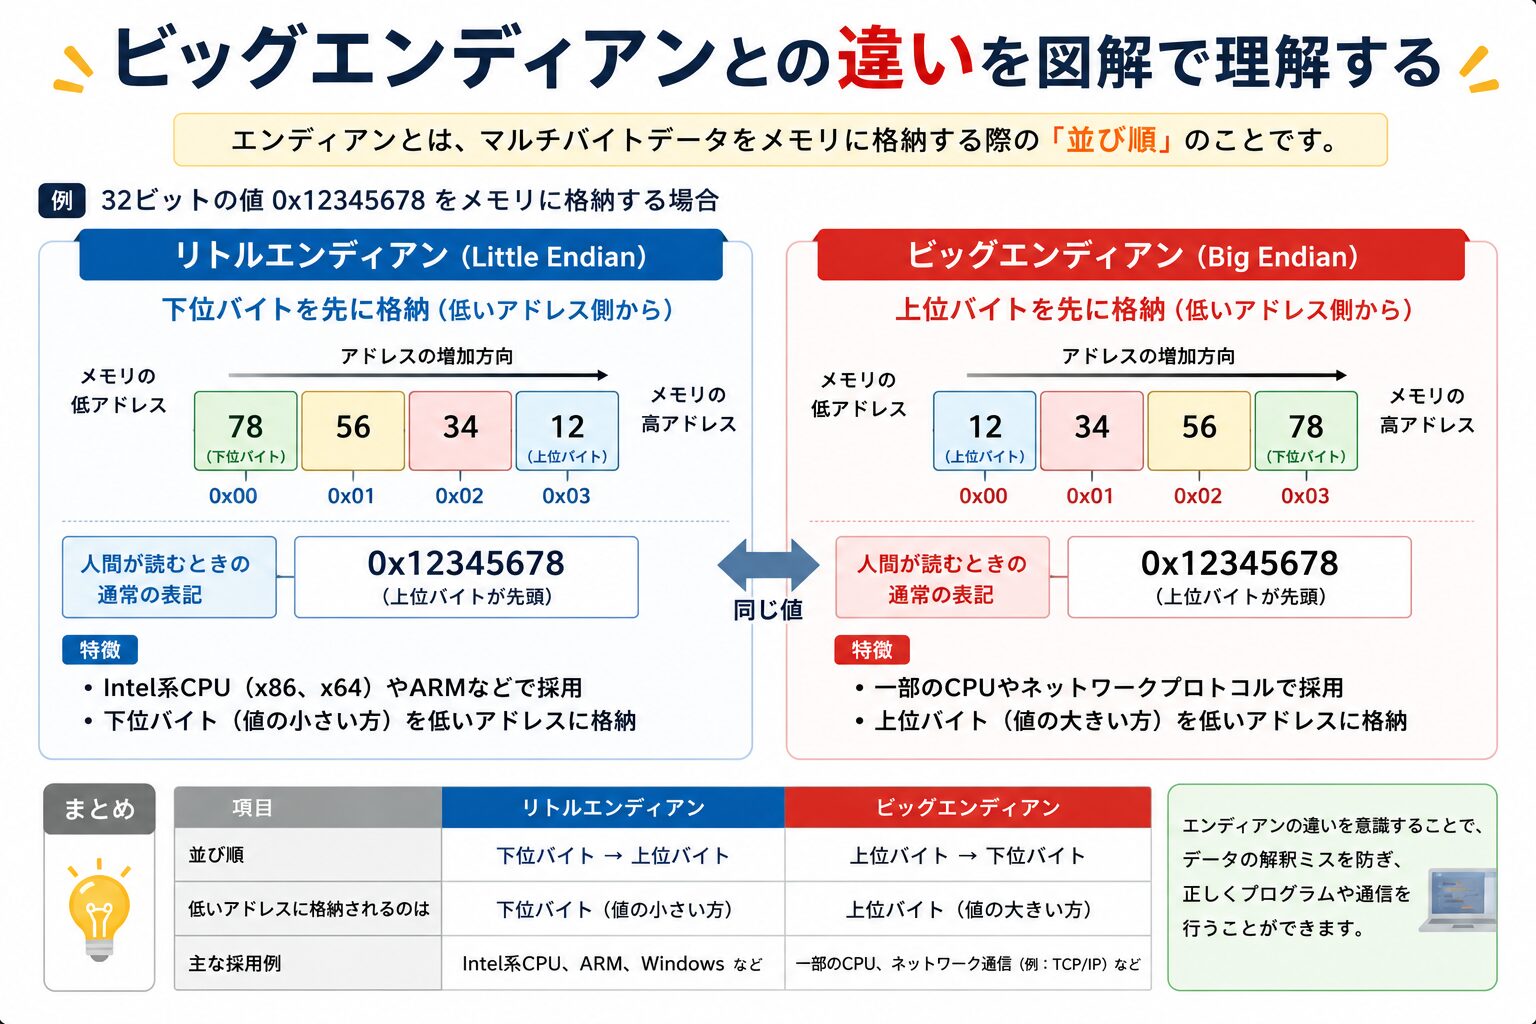
コンピュータの内部で2バイト以上の数値データを扱う際、メモリ上のどの番地にどの桁(バイト)を配置するかという規則がバイト順序(バイトオーダー)です。この配置規則の代表格が「ビッグエンディアン」と「リトルエンディアン」であり、両者の間には明確な思想の違いが存在します。
理解を明確にするため、32ビット(4バイト)の16進数データ「0x12345678」をメモリアドレス(0x1000番地〜0x1003番地)に配置するケースを想定します。この数値において、「12」は最も位が高い最上位バイト(MSB: Most Significant Byte)であり、「78」は最も位が低い最下位バイト(LSB: Least Significant Byte)です。
ビッグエンディアン(Big-Endian)では、データの最上位バイトから順に、小さいメモリアドレスへ格納していきます。つまり、0x1000番地に「12」、0x1001番地に「34」、0x1002番地に「56」、0x1003番地に「78」が入ります。これは私たちが日常で「千二百三十四」と左から順に数字を書く感覚と完全に一致しており、メモリダンプを目視した際に直感的に値を読み取れるのが最大の特徴です。
対照的に、リトルエンディアン(Little-Endian)では、データの最下位バイトから順に小さいメモリアドレスへ格納します。0x1000番地に「78」、0x1001番地に「56」、0x1002番地に「34」、0x1003番地に「12」という逆順の配置になります。一見すると不自然に映りますが、ハードウェアが数値の加減算を行う際、桁上がりの処理を最下位桁から順に進められるため、回路設計やメモリアクセスの面で合理的な利点を備えています。
シンプルで洗練された住まいづくりとインテリアコーディネートのアイデアを提案しています。
