
度数分布表の平均値を完全攻略!階級値と仮平均の使い方を徹底解説

度数分布表の平均値を完全攻略!階級値と仮平均の使い方を徹底解説にまつわる役立つ知識を詳しく紐解きます。
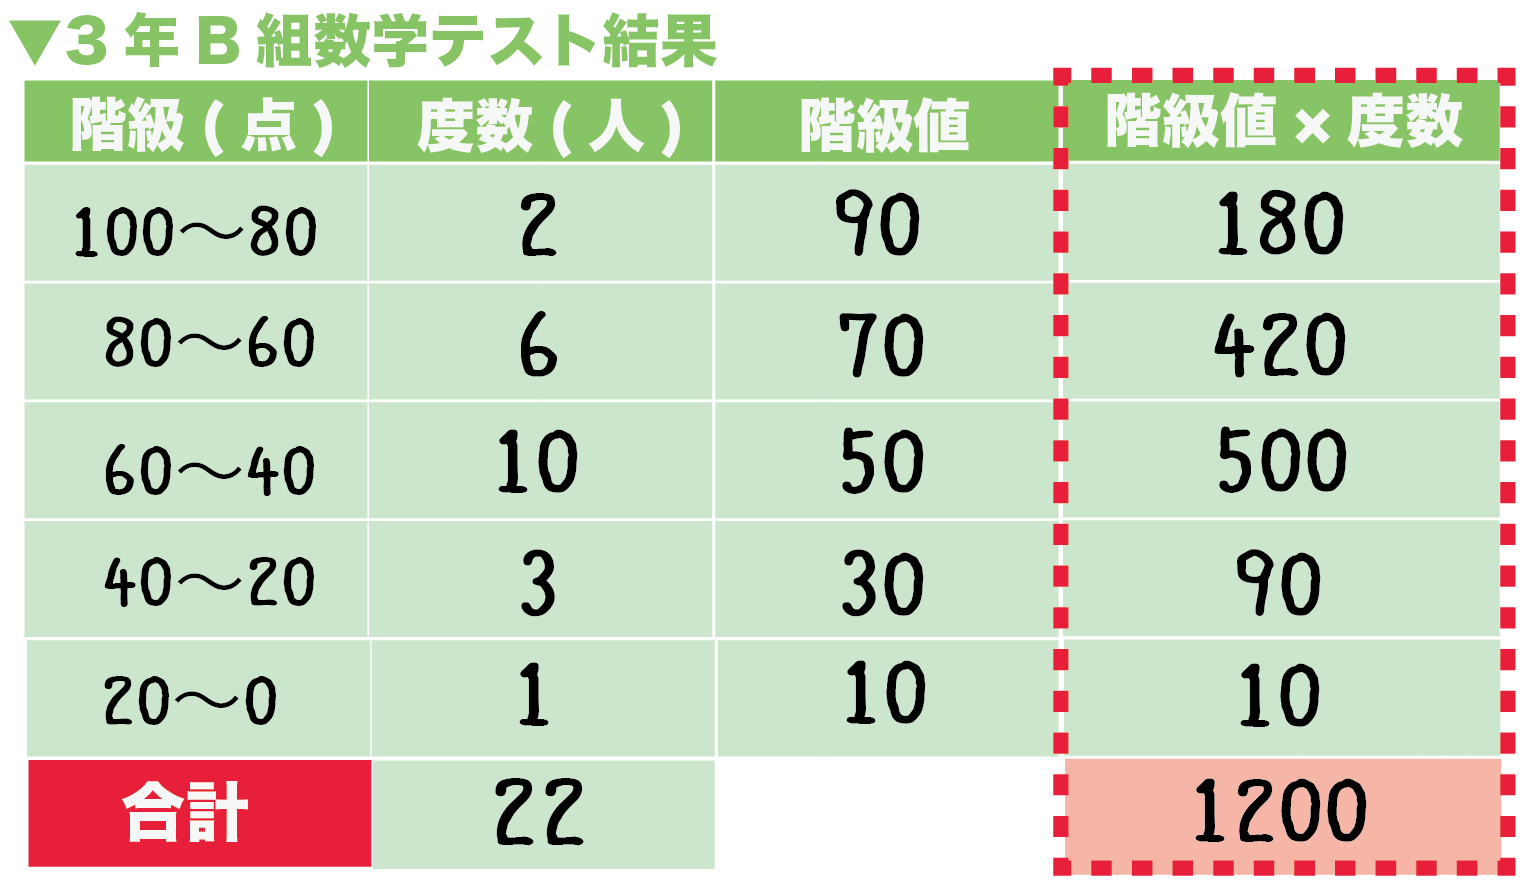
学習者から最も頻繁に寄せられる疑問が、「なぜ生データがないのに階級の真ん中の値(階級値)を使って計算してよいのか」「なぜ元の生データから求めた平均値と微妙にズレるのか」という点です。
度数分布表の成り立ちを振り返ると、表に整理された時点で「13点の生徒が1人、18点の生徒が2人」といった個別の具体的な数値情報は削ぎ落とされ、「10点以上20点未満に3人いる」というグループ情報のみが残ります。元の点数が分からない以上、計算を進めるには階級内のデータを代表する1つの数値を定める必要があります。
数学的に「階級内のデータは中央付近を中心に満遍なく散らばっている」と仮定するのが最も合理的であるため、その区間の中央値である階級値を代表として採用します。
度数分布表の平均値に誤差が生じる理由は、まさにこの「仮定」にあります。例えば「10点以上20点未満(階級値15)」に属する5人の実際の点数が全員「11点」だった場合、生データの合計は55点ですが、階級値を用いる計算では $15 \times 5 = 75$ 点として扱われます。この差額20点が集計全体の誤差として蓄積するわけです。
教育現場を取材した数学科出身の講師陣は、「度数分布表から求める平均値は、あくまで『度数分布表から推測される推定平均値』であることを理解することが、統計リテラシーの第一歩である」と口を揃えます。サンプル数が十分に大きく、分布が極端に偏っていなければ、この誤差は統計的に相殺され、実用上問題のない水準に収まります。
最新のテクノロジーと生活デザインの融合をテーマに、国内外の最新トピックを発信しています。
